跳至内容

LR 与 SVM

LR 与 SVM 的基本原理和数学推导。

  • 机器学习
  • 逻辑回归
  • SVM
  • 支持向量机
  • 线性回归
  • 梯度下降

逻辑回归学习类别概率,SVM 寻找兼顾分类与间隔的边界。 两者都可以从线性得分出发,但对“已经分对的样本”仍有不同要求:逻辑回归继续提高真实类别的概率,hinge 损失则在达到间隔要求后变为 0。

特征处理与评估见机器学习基础,模型差异集中在 FAQ:LR 与 SVM。完整的 SVM 对偶推导 放在文末,可按需阅读。

1. 逻辑回归:从得分到概率

1.1 线性得分、sigmoid 与阈值

对特征向量 x∈Rdx\in\mathbb{R}^d,先计算线性得分,再通过 sigmoid 得到模型估计的正类概率:

s=w⊤x+b,p=P(y=1∣x)=σ(s),σ(s)=11+e−s.\begin{aligned} s &= w^\top x+b,\\ p &= P(y=1\mid x)=\sigma(s),\\ \sigma(s) &= \frac{1}{1+e^{-s}}. \end{aligned}

ww 是特征权重,bb 是偏置。模型直接联合学习它们,无需先训练一个线性回归模型。

有限得分对应的概率位于 (0,1)(0,1)。给定阈值 t∈(0,1)t\in(0,1),p≥tp\ge t 时预测为正类,否则为负类。当 t=0.5t=0.5 时,分类边界是 w⊤x+b=0w^\top x+b=0。

sigmoid 是非线性函数,但普通逻辑回归的分类边界仍是线性的。 调整阈值会移动分类边界,但不会改变已经训练好的概率函数;要表达非线性边界,可以先构造非线性特征。

与线性回归的输出、损失对比见 FAQ:逻辑回归与线性回归。

1.2 为什么使用交叉熵

令 yi∈{0,1}y_i\in\{0,1\},pi=P(yi=1∣xi)p_i=P(y_i=1\mid x_i)。单个样本的真实标签在模型下的概率可以合并写成:

P(yi∣xi)=piyi(1−pi)1−yi.P(y_i\mid x_i)=p_i^{y_i}(1-p_i)^{1-y_i}.

yi=1y_i=1 时取 pip_i,yi=0y_i=0 时取 1−pi1-p_i。在给定特征和参数后,各样本标签独立的假设下,整个训练集的似然是这些概率的乘积:

L(w,b)=∏i=1npiyi(1−pi)1−yi.L(w,b)=\prod_{i=1}^{n}p_i^{y_i}(1-p_i)^{1-y_i}.

似然的作用:固定已观测的数据,比较不同参数对这组数据的解释程度。 它不是阈值分类后“所有样本都预测正确”的概率。

最大化似然等价于最大化对数似然:对数把乘积变成求和,并保持大小关系。再取负号、除以样本数,就得到平均二元交叉熵:

ℓi=−yilog⁡pi−(1−yi)log⁡(1−pi),J(w,b)=−1nlog⁡L(w,b)=1n∑i=1nℓi.\begin{aligned} \ell_i &= -y_i\log p_i-(1-y_i)\log(1-p_i),\\ J(w,b)&=-\frac{1}{n}\log L(w,b)=\frac{1}{n}\sum_{i=1}^{n}\ell_i. \end{aligned}

这里的 log⁡\log 使用自然对数。真实标签为 1 时,pi=0.9p_i=0.9 的损失约为 0.1050.105,pi=0.1p_i=0.1 的损失约为 2.3032.303:越确信地预测错,惩罚越大。真实标签为 0 时则相反。

训练可使用梯度下降等优化方法。对上述平均损失,梯度为:

∇wJ=1n∑i=1n(pi−yi)xi,∂J∂b=1n∑i=1n(pi−yi).\begin{aligned} \nabla_w J&=\frac{1}{n}\sum_{i=1}^{n}(p_i-y_i)x_i,\\ \frac{\partial J}{\partial b}&=\frac{1}{n}\sum_{i=1}^{n}(p_i-y_i). \end{aligned}

梯度中的 pi−yip_i-y_i 是概率估计与标签的差。选择合适的步长,沿梯度的反方向更新参数,可以降低平均损失;这不要求每个样本的损失都下降。加入 L1 或 L2 正则化,还会对较大的权重施加惩罚。

1.3 多分类与多标签

任务常见输出方式损失
二分类一个 sigmoid 概率二元交叉熵
单标签多分类softmax 概率分布多类交叉熵
多标签分类每个标签一个 sigmoid各标签二元交叉熵的汇总

单标签多分类中,每个样本只属于一个类别。对 KK 个类别分别计算得分 sk=wk⊤x+bks_k=w_k^\top x+b_k,softmax 将它们变为总和为 1 的概率:

pk=esk∑j=1Kesj.p_k=\frac{e^{s_k}}{\sum_{j=1}^{K}e^{s_j}}.

对应的多类交叉熵损失为:

ℓ=−∑k=1Kyklog⁡pk=−log⁡pc.\ell=-\sum_{k=1}^{K}y_k\log p_k=-\log p_c.

这里 yky_k 表示样本是否属于第 kk 类:真实类别为 cc,则 yc=1y_c=1,其余 yk=0y_k=0。所以求和中只有真实类别对应的一项保留下来,模型给真实类别的概率越高,损失越小。

单标签多分类也可以拆成多个二分类任务:每次选一个类别作为正类,将其他所有类别合并为负类。这叫一对其余(One-vs-Rest,OvR)。例如识别猫、狗、鸟,就分别训练“猫与非猫”“狗与非狗”“鸟与非鸟”三个分类器,预测时选择得分最高的类别。

多标签分类允许一个样本同时具有多个标签。每个标签分别使用 sigmoid,得到该标签出现的概率 pk=σ(sk)p_k=\sigma(s_k),各标签概率之和不必为 1。单个样本的损失可以将各标签的二元交叉熵相加:

ℓ=−∑k=1K[yklog⁡pk+(1−yk)log⁡(1−pk)].\ell=-\sum_{k=1}^{K}\left[y_k\log p_k+(1-y_k)\log(1-p_k)\right].

此处 yk=1y_k=1 表示样本具有第 kk 个标签,yk=0y_k=0 表示不具有;多个 yky_k 可以同时为 1。

2. SVM:用间隔约束分类边界

用 +1+1 和 −1-1 分别表示正类与负类,即 yi∈{−1,+1}y_i\in\{-1,+1\}。线性得分记为 f(x)=w⊤x+bf(x)=w^\top x+b。

得分的正负决定类别,f(x)=0f(x)=0 是分隔超平面。在二维空间中,它就是一条直线;ww 与它垂直,固定 ww 后改变 bb,会使边界平行移动。SVM 的得分本身不是概率,需要概率输出时还要做概率校准。

2.1 硬间隔与支持向量

点 xx 到超平面的距离为:

r=∣w⊤x+b∣∥w∥.r=\frac{|w^\top x+b|}{\lVert w\rVert}.

对线性可分的训练集,先取一个能正确分类的超平面,再按同一正数缩放 w,bw,b,使最近样本满足 yif(xi)=1y_i f(x_i)=1。

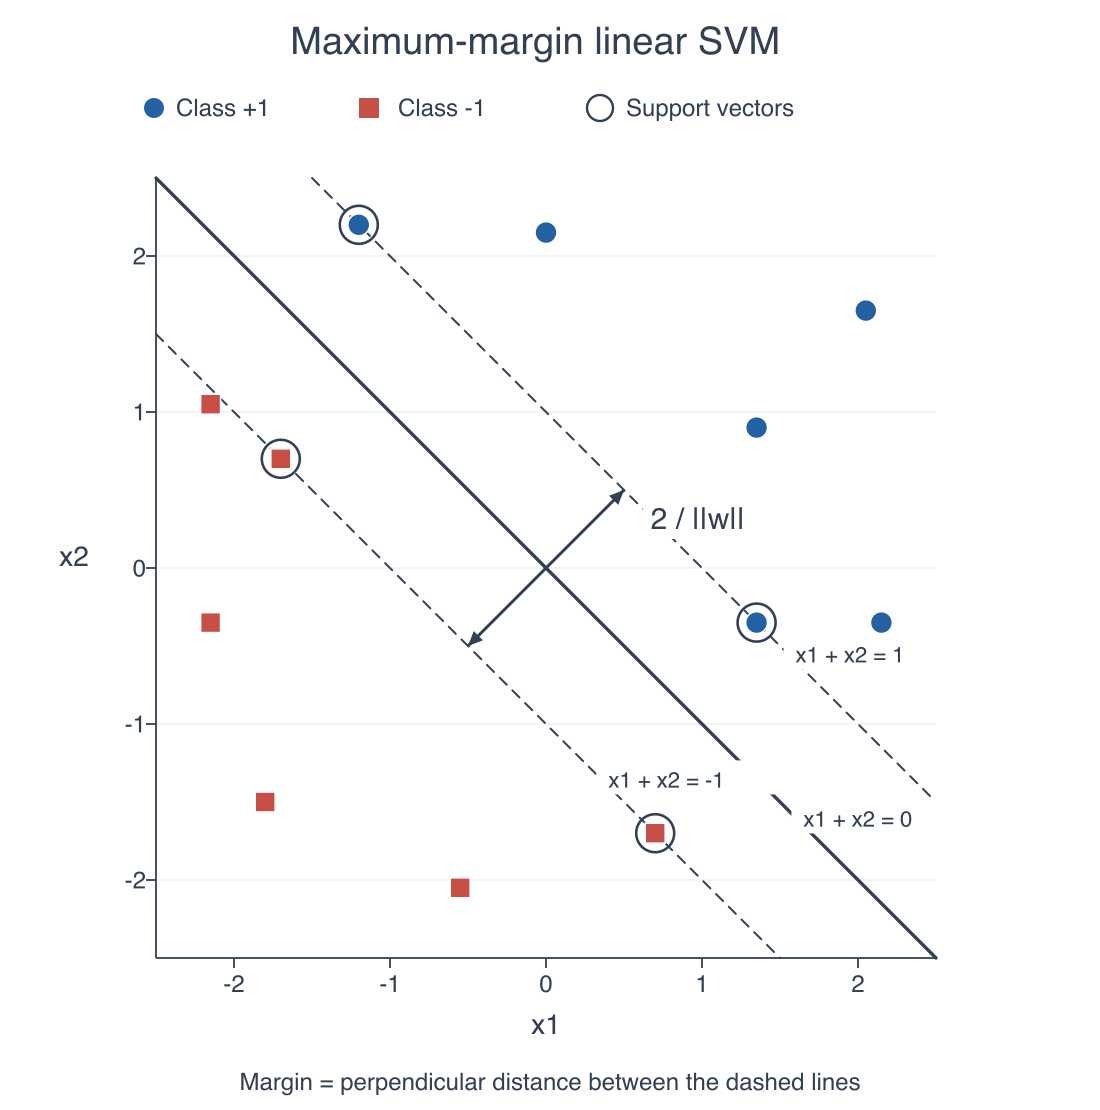
两侧的间隔边界为 f(x)=±1f(x)=\pm1,各距决策边界 1∥w∥\displaystyle\frac{1}{\lVert w\rVert},间隔带总宽度为 2∥w∥\displaystyle\frac{2}{\lVert w\rVert}。

线性 SVM 的两类样本、决策边界和两侧支持超平面,双向箭头标出间隔宽度

图中实线是决策边界,虚线是两侧的支持超平面,外圈标出支持向量。硬间隔 SVM 要在正确分开所有训练样本的同时,让间隔带最宽。 最大化 2∥w∥\displaystyle\frac{2}{\lVert w\rVert} 等价于最小化 12∥w∥2\displaystyle\frac{1}{2}\lVert w\rVert^2:

min⁡w,b12∥w∥2s.t.yi(w⊤xi+b)≥1,i=1,…,n.\begin{aligned} \min_{w,b}\quad &\frac12\lVert w\rVert^2\\ \text{s.t.}\quad &y_i(w^\top x_i+b)\ge1,\quad i=1,\ldots,n. \end{aligned}

硬间隔要求训练集线性可分。一个异常点就可能显著改变分隔边界,甚至让约束无解。

2.2 软间隔与 hinge loss

软间隔允许部分样本进入间隔带,甚至被分错,并用松弛变量 ξi\xi_i 记录对间隔约束的违反程度:

min⁡w,b,ξ12∥w∥2+C∑i=1nξis.t.yi(w⊤xi+b)≥1−ξi,ξi≥0.\begin{aligned} \min_{w,b,\xi}\quad &\frac12\lVert w\rVert^2+C\sum_{i=1}^{n}\xi_i\\ \text{s.t.}\quad &y_i(w^\top x_i+b)\ge1-\xi_i,\quad \xi_i\ge0. \end{aligned}

C>0C>0 控制两项目标的权衡:较大的 CC 更重视减少间隔违反,较小的 CC 更重视控制权重范数。具体取值通过验证集选择。

令 zi=yif(xi)z_i=y_i f(x_i)。约束要求 ξi≥1−zi\xi_i\ge1-z_i 且 ξi≥0\xi_i\ge0;目标又会惩罚较大的 ξi\xi_i,所以固定 w,bw,b 后,最优的松弛量就是 hinge loss:

ξi∗=ℓhinge(zi)=max⁡(0,1−zi).\xi_i^*=\ell_{\mathrm{hinge}}(z_i)=\max(0,1-z_i).

将它代回目标,软间隔 SVM 就是在最小化 12∥w∥2+C∑iℓhinge(zi)\dfrac{1}{2}\lVert w\rVert^2+C\sum_i\ell_{\mathrm{hinge}}(z_i)。惩罚的不只是错分,还包括分对但间隔不足的样本:

  • zi≥1z_i\ge1:分类正确且达到间隔要求,损失为 0。
  • 0<zi<10<z_i<1:分类正确,但进入间隔带,仍有损失。
  • zi<0z_i<0:分类错误,损失大于 1;zi=0z_i=0 位于决策边界。

软间隔下,支持向量也可能位于间隔带内或错误一侧,不能一律解释成“离超平面最近的点”。

对偶解中系数 αi>0\alpha_i>0 的样本参与构成分类函数,具体关系见文末推导。

2.3 0/1、hinge 与 logistic 损失

仍用 y∈{−1,+1}y\in\{-1,+1\},令 z=yf(x)z=yf(x)。z>0z>0 表示分类方向正确,z<0z<0 表示分类错误。

对逻辑回归,真实类别的概率可统一写成 σ(z)\sigma(z),前面的二元交叉熵就是 −log⁡σ(z)-\log\sigma(z),也称 logistic 损失。用这个形式与另外两种损失比较:

ℓ0/1(z)=1[z≤0],ℓhinge(z)=max⁡(0,1−z),ℓlogistic(z)=−log⁡σ(z)=log⁡(1+e−z).\begin{aligned} \ell_{0/1}(z)&=\mathbf{1}[z\le0],\\ \ell_{\mathrm{hinge}}(z)&=\max(0,1-z),\\ \ell_{\mathrm{logistic}}(z)&=-\log\sigma(z)=\log(1+e^{-z}). \end{aligned}

式中的 log⁡\log 表示自然对数,1\mathbf{1} 表示条件成立取 1,否则取 0;这里约定 z=0z=0 也计入 0/1 错误。

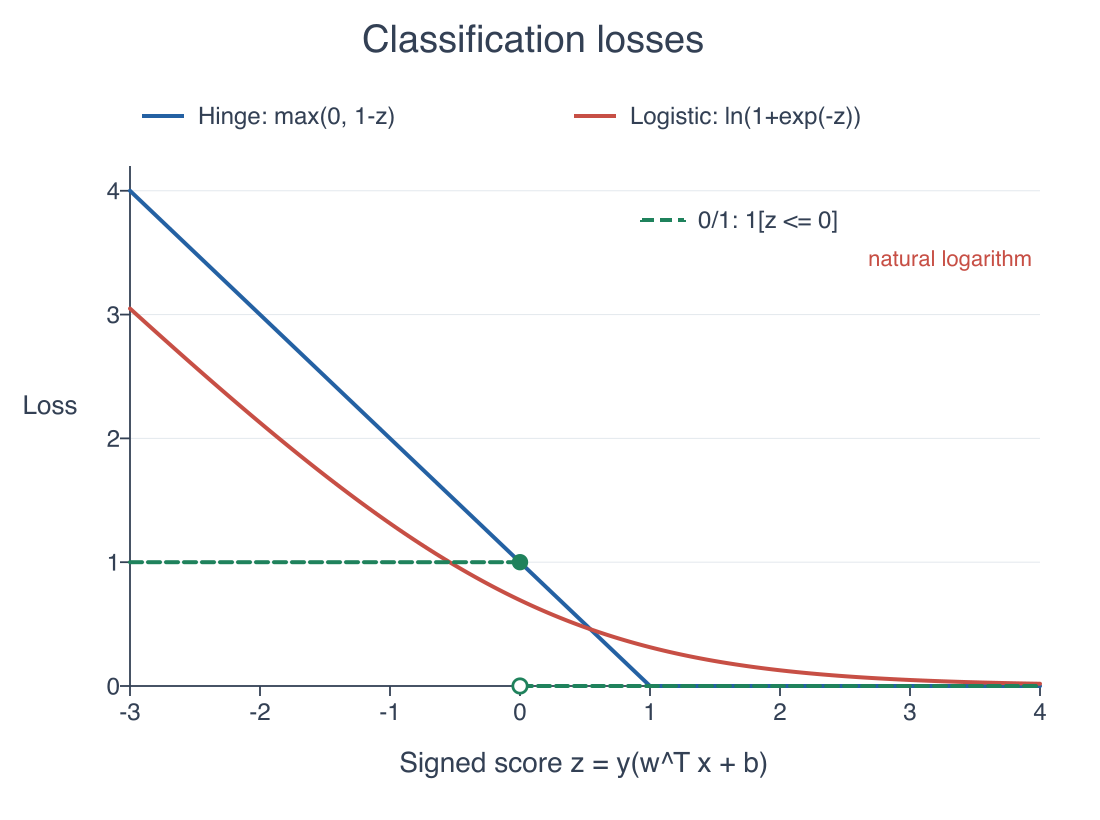
0/1、hinge 与 logistic 损失随有符号得分变化的曲线

图中横轴是有符号得分 zz,纵轴是损失值。损失为 0,表示不再惩罚这个样本。

  • 0/1 损失:分对就不再惩罚。 分错或恰好位于分类边界(z≤0z\le0)时,损失为 1;只要进入正确一侧(z>0z>0),损失就变为 0,不再关心离边界多远。
  • hinge 损失:分对后,还要达到间隔要求。 在分类边界(z=0z=0)处,损失为 1;进入正确一侧后,损失随得分线性减小。分对但间隔不足(0<z<10<z<1)时,仍有损失;达到间隔要求(z≥1z\ge1)后,损失才归零。
  • logistic 损失:分对后,仍鼓励提高真实类别的概率。 在分类边界(z=0z=0)处,损失为 log⁡2≈0.693\log2\approx0.693。当得分达到 z=1z=1 时,hinge 损失已经归零,logistic 损失仍约为 0.313。继续增大得分,损失会平滑下降并趋近 0,但只要得分有限,损失就始终大于 0。

2.4 核函数怎样处理非线性

在特征空间中是线性的边界,回到原始空间后可以是非线性的。

例如数轴上的三个样本:x=−2x=-2 和 x=2x=2 属于正类,夹在中间的 x=0x=0 属于负类。一个阈值只能将数轴分成左右两部分,无法同时把两端的正类与中间的负类分开。

增加一个平方特征,将样本映射为 ϕ(x)=(x,x2)\phi(x)=(x,x^2)。这样就从数轴上的一个数,变成了平面上的一个点:横坐标是原来的 xx,纵坐标是新增的 x2x^2。

原样本 x类别新坐标 (x, x²)
-2正类 +1(-2, 4)
0负类 -1(0, 0)
2正类 +1(2, 4)

两个正类点的纵坐标都是 4,负类点的纵坐标是 0。在纵坐标为 2 的位置画一条水平直线,就能把正类留在上方、负类留在下方。

这条直线对应 x2=2x^2=2。回到原来的数轴,它变成两个分界点 x=±2x=\pm\sqrt2:两端预测为正类,中间预测为负类。平方特征使新平面上的一条直线,表达了原数轴上需要两个分界点的分类规则。

特征映射可能产生很多维度。SVM 的对偶目标与预测只依赖样本内积,核函数可以直接计算映射后的内积:

k(x,x′)=ϕ(x)⊤ϕ(x′).k(x,x')=\phi(x)^\top\phi(x').

ϕ\phi 是特征映射,kk 才是核函数。 用 kk 替换内积,就能在不显式构造高维向量的情况下训练和预测,这就是核技巧。下面列出线性核、多项式核和 RBF 核(Radial Basis Function,径向基函数核),其中 RBF 采用高斯形式:

klinear(x,x′)=x⊤x′,kpoly(x,x′)=(γx⊤x′+r)q,kRBF(x,x′)=e−γ∥x−x′∥2.\begin{aligned} k_{\mathrm{linear}}(x,x')&=x^\top x',\\ k_{\mathrm{poly}}(x,x')&=(\gamma x^\top x'+r)^q,\\ k_{\mathrm{RBF}}(x,x')&=e^{-\gamma\lVert x-x'\rVert^2}. \end{aligned}

多项式核中,常取 γ>0,r≥0\gamma>0,r\ge0,qq 为正整数。

RBF 核中 γ>0\gamma>0,也可写为 γ=12σ2\displaystyle\gamma=\frac{1}{2\sigma^2}:γ\gamma 越大,相似度随距离下降越快,边界可能更局部、更复杂。

另外两种常见形式是:

  • 拉普拉斯核:e−γ∥x−x′∥1e^{-\gamma\lVert x-x'\rVert_1},其中 γ>0\gamma>0,∥⋅∥1\lVert\cdot\rVert_1 表示各维绝对值之和。
  • sigmoid 核:tanh⁡(γx⊤x′+r)\tanh(\gamma x^\top x'+r)。这里的 tanh⁡\tanh 与逻辑回归中的 sigmoid 函数不同,而且并非任意参数都满足正半定核条件,即不一定能表示某个特征空间中的内积。

核方法增加了可表达的边界形状,但不能保证新数据上分类正确。实际使用时,需要结合数据选择核和参数:

  • 特征尺度:SVM 的间隔和核值都受尺度影响。RBF 核依赖距离,某一维数值范围过大时,可能主导距离;应先确定特征缩放,再联合选择 CC 和 γ\gamma。
  • 训练成本:核 SVM 的训练开销随样本数快速增长。样本很多、特征高维且稀疏时,可优先比较逻辑回归或线性 SVM 等线性模型。

3. 附:SVM 从原始问题到对偶问题

以下推导假设二分类训练集线性可分,yi∈{−1,+1}y_i\in\{-1,+1\},先使用线性特征。需要理解向量内积与偏导;约束优化中的必要概念在对应步骤说明。

3.1 为什么约束可以写成大于等于 1

取一个正确分开训练集的超平面,记最小有符号得分为 m=min⁡iyi(w⊤xi+b)>0m=\min_i y_i(w^\top x_i+b)>0。同时将 w,bw,b 除以 mm,不会改变分类边界或类别判断,却会使最小有符号得分恰好等于 1。因此约束可以统一写为 yi(w⊤xi+b)≥1y_i(w^\top x_i+b)\ge1。

此时最大化间隔宽度 2∥w∥\displaystyle\frac{2}{\lVert w\rVert},等价于最小化 12∥w∥2\displaystyle\frac{1}{2}\lVert w\rVert^2,得到前面的硬间隔原始问题。

3.2 把约束放入拉格朗日函数

将每条约束写成 1−yi(w⊤xi+b)≤01-y_i(w^\top x_i+b)\le0,引入非负乘子 αi\alpha_i:

L(w,b,α)=12∥w∥2+∑i=1nαi[1−yif(xi)],αi≥0.\begin{aligned} L(w,b,\alpha)&=\frac12\lVert w\rVert^2+\sum_{i=1}^{n}\alpha_i[1-y_i f(x_i)],\\ \alpha_i&\ge0. \end{aligned}

固定 w,bw,b 后,分两种情况:

  • 违反约束:对应括号为正,增大 αi\alpha_i 就能让 LL 无界增大。
  • 满足全部约束:每个括号都非正,取 α=0\alpha=0 就能让附加项达到最大值 0,还原原目标。

因此原始问题可写成 min⁡w,bmax⁡α≥0L\min_{w,b}\max_{\alpha\ge0}L:违反约束的参数被赋予无穷大的目标值,可行参数则保留原目标值。

对偶问题将顺序改为 max⁡α≥0min⁡w,bL\max_{\alpha\ge0}\min_{w,b}L。一般情况下,两者不能随意交换。

这里目标凸、约束仿射,且线性可分时存在严格可行点,满足强对偶条件,因此两者最优值相等。

3.3 消去原参数

固定 α\alpha,对 w,bw,b 求偏导并令其为零:

∇wL=w−∑i=1nαiyixi=0,∂L∂b=−∑i=1nαiyi=0.\begin{aligned} \nabla_w L&=w-\sum_{i=1}^{n}\alpha_i y_i x_i=0,\\ \frac{\partial L}{\partial b}&=-\sum_{i=1}^{n}\alpha_i y_i=0. \end{aligned}

因此 w=∑iαiyixiw=\sum_i\alpha_i y_i x_i。对 bb 的导数则要求 ∑iαiyi=0\sum_i\alpha_i y_i=0:若它不为 0,LL 中就留有系数非零的 bb 一次项,调整 bb 可使 L→−∞L\to-\infty,无法得到有限的内层最小值。

把两者代回 LL:含 bb 的项消失,含 ww 的两项合并为 −12∥w∥2\displaystyle-\frac{1}{2}\lVert w\rVert^2。对偶目标就只剩 α\alpha:

max⁡α∑i=1nαi−12∑i,j=1nαiαjyiyjxi⊤xj,s.t.αi≥0,∑i=1nαiyi=0.\begin{aligned} \max_{\alpha}\quad &\sum_{i=1}^{n}\alpha_i-\frac12\sum_{i,j=1}^{n}\alpha_i\alpha_j y_i y_j x_i^\top x_j,\\ \text{s.t.}\quad &\alpha_i\ge0,\quad \sum_{i=1}^{n}\alpha_i y_i=0. \end{aligned}

3.4 为什么只保留支持向量

KKT 条件全称为 Karush–Kuhn–Tucker 条件(卡鲁什–库恩–塔克条件),是一组用于约束优化的最优性条件。

在这里,最优解需要同时满足原问题的间隔约束、乘子非负、上一节的偏导为零,以及下面的互补松弛条件:

αi∗[yi(w∗⊤xi+b∗)−1]=0.\alpha_i^*[y_i(w^{*\top}x_i+b^*)-1]=0.

星号表示最优解。互补松弛要求乘子与“超出间隔要求的量”相乘为 0,因此:

  • 如果 αi∗>0\alpha_i^*>0,括号必须为零,该样本就在支持超平面上。
  • 如果样本严格位于间隔带外,括号大于零,则 αi∗=0\alpha_i^*=0,不参与 w∗w^* 的求和。

取一个 αj∗>0\alpha_j^*>0 的支持向量,可恢复参数:

w∗=∑i=1nαi∗yixi,b∗=yj−w∗⊤xj.\begin{aligned} w^*&=\sum_{i=1}^{n}\alpha_i^*y_i x_i,\\ b^*&=y_j-w^{*\top}x_j. \end{aligned}

对偶目标与预测都只依赖样本内积。将内积替换为核函数,就得到核 SVM 的预测形式:

f(x)=∑i=1nαi∗yik(xi,x)+b∗,y^=sign⁡(f(x)).\begin{aligned} f(x)&=\sum_{i=1}^{n}\alpha_i^*y_i k(x_i,x)+b^*,\\ \hat y&=\operatorname{sign}(f(x)). \end{aligned}

若得分恰好为 0,需要约定归入哪类。特征映射后的超平面满足 w∗⊤ϕ(x)+b∗=0w^{*\top}\phi(x)+b^*=0;预测时使用核函数即可,无需显式求出高维的 w∗w^*。

对于前面的软间隔目标,对偶目标形式不变,约束变为 0≤αi≤C0\le\alpha_i\le C,并保留 ∑iαiyi=0\sum_i\alpha_i y_i=0。其中 0<αj<C0<\alpha_j<C 的样本满足 yjf(xj)=1y_jf(x_j)=1,可用来恢复 bb;若没有这样的点,则需依据 KKT 条件确定可行的偏置,不能套用任意支持向量。

SMO(序列最小优化)用来求解这一对偶问题。由于 ∑iαiyi=0\sum_i\alpha_i y_i=0,固定其余乘子后,只改变一个乘子就会破坏等式;同时调整两个乘子,才能在保持等式的同时改进目标。因此 SMO 每次选择两个乘子优化,并满足各自的上下界,将大问题拆成容易求解的小问题。

评论

使用 GitHub 登录后参与讨论,评论将公开保存在 GitHub。

阅读到这里时加载评论。