RSI 递归自我改进:机制与证据
RSI 的工作原理、核心公式,以及 STOP 和 DGM 的具体做法。
递归自我改进(Recursive Self-Improvement,RSI)是让 AI 改进自身,再用改进后的系统继续完成下一轮自我改进。 新版本既是上一轮的产物,也参与产生下一版;“递归”就发生在这里。
这件事为什么值得研究呢?假如一个编程 Agent 改好了自己定位错误的工具,它以后修改自身代码时也能用上这个工具。一次改进便可能帮助它找到下一次改进。不过,这种帮助是否真的发生,需要通过实验判断,不能由“运行了很多轮”直接推出。
1. RSI 的改进对象
一个编程 Agent 通常由 LLM 和 Harness 共同组成。LLM 根据上下文生成操作,Harness 负责工具调用、文件读写、测试执行、状态管理,以及重试和终止控制。
因此,Agent 的自我改进不一定涉及 LLM 参数更新。搜索工具、Prompt、Memory 检索策略和执行流程都可以成为修改对象。即使 LLM 权重固定,Harness 的变化仍会影响 Agent 获取的信息和执行行为。
在 Agent 系统中,Harness 是围绕模型构建的运行框架,负责组织模型调用与工具执行、管理上下文和状态、接入运行环境,并控制执行权限与边界,使模型能够持续完成多步骤任务。
以一个负责修复业务项目的 Agent 为例,可以区分三种情况:
| 发生了什么 | 被改变的对象 | 下一轮发生什么 |
|---|---|---|
| 看见测试报错后,修复业务函数 | 用户项目中的代码 | Agent 继续按原有方法工作 |
| 改好自己的文件搜索工具 | Agent 的工具代码 | 新工具用于后续业务任务 |
| 用改好的搜索工具继续修改自身程序 | Agent 本身及其改进过程 | 前一轮的改动参与了后一轮自修改 |
第一种是常见的代码修复。第二种说明改动可以长期复用。第三种才展示了这里讨论的递归关系:改进后的系统重新参与改进自身。
在更广的研究中,可修改对象也包括训练数据、模型参数和实验流程。是否构成递归,取决于改动是否参与后续改进过程,不能仅凭它修改了 Prompt、Harness 还是模型参数来判断。
2. STOP:Improver 的自应用
2.1 从任务代码优化到自修改
Improver(改进程序) 接收初始代码和评分函数,调用 LLM 生成候选方案,执行评测并返回得分最高的候选。将初始版本记为 。这里的 Improver 是组织 LLM 调用与候选搜索的程序,LLM 本身不随它的版本更新。
普通使用时,它处理的是某个任务的解答代码。例如,输入一个搜索算法,让它在结果正确的前提下减少运行时间。输入、修改和评分都围绕这个任务展开;负责组织这些步骤的 没有改变。
STOP(Self-Taught Optimizer)将 用于自修改:输入换成 的源码,评分目标换成候选 Improver 在下游任务上的改进效果。 选出的新 Improver 再执行下一轮自修改。
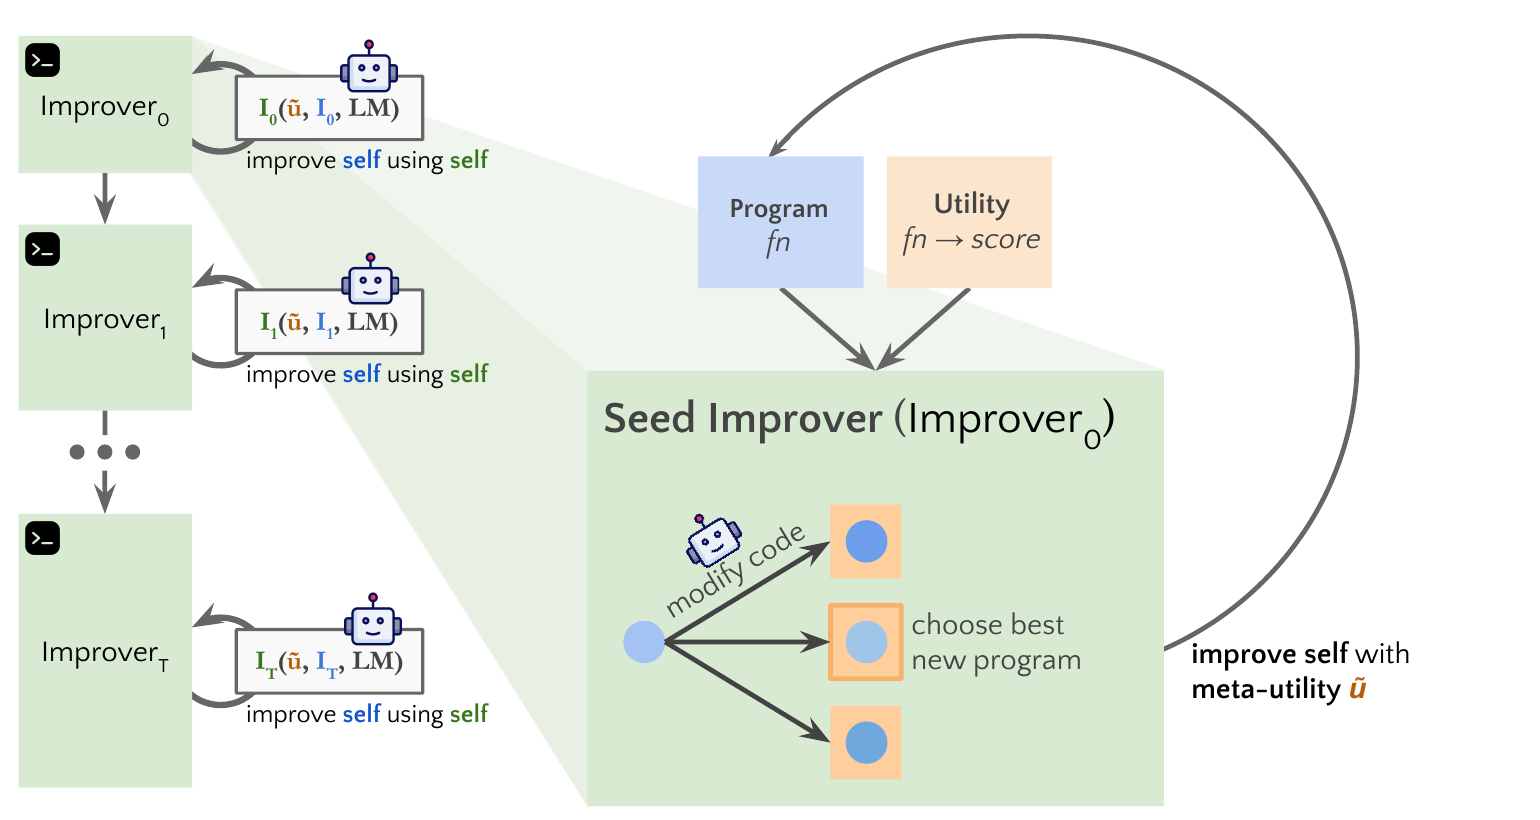
图右侧展示单轮处理,左侧展示版本迭代:
- 输入:
Program是待改源码,Utility是评分函数。 - 生成与选择:
Seed Improver调用 LLM 修改输入,评测多个候选并选优。 - 自应用: 沿外侧回箭头,将输入替换为 Improver 自身源码,评分函数替换为
meta-utility。 - 版本接续: 左侧的 表示新 Improver 接手后续迭代。
2.2 Meta-utility:如何评价 Improver
任务评分评价修改后的任务程序,meta-utility 评价产生这些修改的 Improver。
候选 Improver 的评测分为三步:
- 逐个启动候选 Improver,让它们修改同一批下游任务的初始代码。
- 执行修改后的任务程序,按各任务的评分函数计算结果。
- 汇总平均任务得分,返回给当前 Improver,用于选择候选版本。
因此,评分依据是下游任务的执行结果,不是 LLM 对候选源码的直接评价。
2.3 递推关系:执行程序与源码输入
在 STOP 中,第 版 Improver 修改自身源码,生成下一版 ,这一过程可表示为:
- 括号外的 是执行程序:当前运行的 Improver,负责调用 LLM、生成候选和选择结果。
- 括号内的 是源码输入:同一版本的源码文本,作为待修改对象传入 Improver。
- 是固定的 LLM。
- 是上一节定义的
meta-utility,原图用 标记同一评分角色。 - 是输出的新 Improver,随后由它执行下一轮自修改。
两处 分别表示可执行程序与源码文本。实现时可以先持久化新版本,再启动新进程,不要求在运行中热替换当前程序。
2.4 两轮迭代示例
下面用两轮假设说明,具体改动是教学示例,不代表论文中的某次实验:
- 第一轮:。 以自身源码为输入,调用 LLM 生成候选版本。假设其中一个候选增加了“读取测试失败信息,将报错传给 LLM 继续修订”的步骤。评测时,让它实际改进一批任务程序,根据结果判断这项改动是否有效;选中的版本记为 。
- 第二轮:。 启动 ,由它继续修改自身源码。此时,上一轮新增的失败反馈机制已经参与工作:候选程序在评测中报错后, 会将报错传给 LLM 继续修订。它可能生成带有错误定位能力的新候选,再经过评测和选择,得到 。
如果第二轮仍由 修改 的源码,负责生成和修订候选的仍是旧版 , 新增的失败反馈机制没有用于组织这一轮改进。STOP 的递归迭代需要把执行者也更新为 ,让上一轮保留的改动参与下一轮自修改。
这一递推式描述的是版本更新过程,并不保证 的性能优于 。在 STOP 的实验中,GPT-4 支持的 Improver 获得了性能收益,而较弱 LLM 的对应实验出现了退化。这说明递归迭代能否带来收益,仍取决于具体的 LLM 和评测条件。
STOP 的修改范围也有限:它更新的是组织 LLM 调用和候选搜索的 Improver,基座 LLM 的参数始终不变。作者因此将这项工作定位为程序层面的递归自我改进,并未声称实现了完整 RSI。
3. DGM:基于 Archive 的分支探索
Darwin Gödel Machine(DGM)维护一个 Archive(Agent 版本档案),从历史版本中选择父代继续探索。每个版本包含自己的工具和运行代码,基座 LLM 保持固定。它与前述线性迭代的主要区别,是允许从多个历史分支继续搜索。
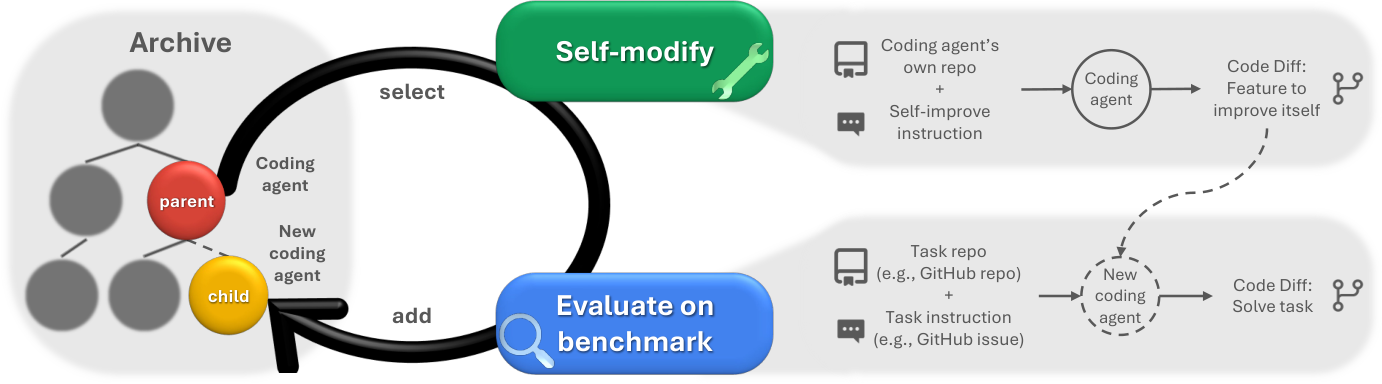
3.1 运行流程
- 选择父代。 从左侧 Archive 中选取一个 Agent 版本。
- 执行自修改。 父代修改右上
Coding agent’s own repo,即 Agent 自身仓库,更新工具或执行流程,产生子代。 - 评测子代。 在右下
Task repo中运行新 Agent,评价它解决编程任务的表现。 - 更新 Archive。 符合入档条件的子代进入 Archive,后续可以被选为父代。保存的是 Agent 版本,不是任务仓库中的业务补丁。
3.2 为什么保留多个历史版本
当前得分较低的版本,也可能提供有价值的搜索起点。 DGM 找到过文件编辑工具和补丁选择流程方面的改动,它们也能用于后续自修改。官方展示的演化树中,有些最终有效的分支经过了暂时低于父代成绩的版本。因此,DGM 不只从当前最高分版本出发;可运行、仍具备编辑能力的候选也可以保留在 Archive 中。
进入 Archive 不等于部署为默认版本,也不表示候选已被证明更好。Archive 服务于搜索,部署选择需要单独决定。
3.3 实验结果与限制
- 任务表现。 SWE-bench Verified 的 200 题子集成绩从 20.0% 提升到 50.0%,完整 Polyglot 基准从 14.2% 提升到 30.7%。收益限定于相应评测范围。
- 自修改范围。 父代选择和 Archive 维护仍由固定外层规则控制,基座 LLM 也没有更新。
- 验证方式。 经典 Gödel Machine 要在形式系统中证明修改有益;DGM 使用任务执行和评测反馈,未提供同样的形式化保证。
4. 如何验证自我改进有效
DGM 的编程成绩从 20.0% 提升到 50.0%,说明新 Agent 在相应任务上表现更好。若要进一步判断它是否更擅长改进自己,就需要让新旧版本分别承担修改 Agent 程序的工作,再比较它们产生的后继版本。
4.1 任务表现与改进能力分别怎样评测
前面两项研究使用的评分,评价对象并不相同:
- DGM 的编程任务得分: 运行新 Agent,让它完成编程任务,检查执行结果。评测的是 Agent 自己做任务的能力。
- STOP 的 meta-utility: 运行候选 Improver,让它修改下游任务程序,再执行这些程序并汇总得分。评测的是 Improver 优化任务代码的能力。
因此,meta-utility 已经是在评价一种改进能力。但把搜索算法等任务代码改得更好,并不保证也能把 Improver 自身改得更好。STOP 作者也指出,更好的下游任务 Improver 未必更擅长优化自身。
Improver Gain 指保留的改动让后续改进过程更有效。 对本文的自修改例子而言,要检验的是: 新增的失败反馈机制,能否帮助它继续产生更好的 Improver。meta-utility 可以用于评价产物,是否获得 Improver Gain 则需要比较新旧机制下的结果。
4.2 用失败反馈的例子做一次对照
在第 2.4 节中, 已经用新增的失败反馈继续修改自身。调用记录若能确认这一点,就说明上一轮的改动参与了下一轮,即发生了递归继承。但反馈机制被使用,不等于它确实有帮助。
要检验收益,可以另外安排下面的对照实验。这是沿用前例设计的评测方案,不是 STOP 论文中的额外实验:
- 让两个执行者修改同一份源码。 准备两份相同的 源码副本,一份交给旧版 修改,另一份交给新版 修改。待改对象相同,区别在于运行哪一版 Improver。
- 保持选择条件和预算可比。 两组使用相同的 LLM、工具权限、候选评分任务与总计算预算。失败后的重试也计入预算。
- 评价两组产出的新 Improver。 分别启动各组选出的新版本,让它们改进同一批未参与版本选择的下游任务代码,再计算这些任务程序的执行得分。这里沿用第 2.2 节的 meta-utility 评测方法,但使用独立的评测任务和相同的评测预算。共同起点 也接受这项评测,用于检查后继版本是否真的优于起点。
- 重复比较。 多次运行上述实验,报告平均得分、波动和失败率,判断差异能否在重复运行中保持。
这里比较的是 和 各自产出的新 Improver,而不是直接比较 和 的任务成绩。 使用共同源码,是为了排除待改对象不同造成的影响;实际递归运行时,仍由新版本接手自修改。
如果 组产出的新 Improver 在独立评测中稳定优于 组,就支持 在这一实验设置下更擅长继续改进 Improver。但若两组都低于共同起点,优势就可能只是退化较少。要进一步把收益归因于失败反馈,还应关闭执行者 中的反馈步骤,保持待改源码副本不变,观察收益是否减弱或消失。
如果系统不允许执行者与待改源码分离,只能让新旧版本各自修改自身,就要同时报告起点成绩与后续增益,并说明起点差异仍会影响归因。
Weco 的 AIDE² 实验也做了角色替换:把改进后的 Agent 放到负责修改其他 Agent 程序的位置,与原来手工设计的改进者比较。新版用更少步骤达到相近成绩,但效率差异未达到统计显著性,因此还不足以确认改进者本身变得更有效。
4.3 用公式表示这项比较
上面的实验比较了同一改进任务在新旧机制下的结果。《Towards AI That Improves Itself》第 3.2 节将这类收益写成“递归进步”的判据:
左边表示继承改动后,后续改进过程的期望效用;右边表示保留旧状态时,同一改进任务的期望效用。 对应刚才的例子:
- 是系统状态, 是 Memory。 旧状态中运行的是 ,新状态中运行的是带有失败反馈的 。本例只考察程序改动,可以保持两组初始 Memory 一致;更一般的自我改进也可以修改 Memory 中保留的经验。
- 是后续第 轮的改进过程,。 在例子中,它包括对同一份 Improver 源码生成候选、执行评测并选择新版本。继承的程序状态决定这一过程是否采用失败反馈。
- 衡量这次改进的效用。 在上述等预算实验中,可以用产出的新 Improver 在独立任务上的 meta-utility 衡量;其他研究也可以将成本和能力退化计入 。
- 表示期望值。 LLM 生成和搜索结果具有随机性,需要重复运行来估计,单次选出一个高分版本还不够。
这个不等式是需要实验支持的效果判据,并非递归迭代自动满足的性质。即使一次比较支持 Improver Gain,也不能据此推出持续加速;后者还需要观察改进效率是否在多轮迭代中继续提高,并检查结果能否跨任务成立。
5. 评测为什么可能误判
第 4 节的比较依赖两个条件:评分能反映实际效果,计算预算能够比较。任一条件失效,都可能让实验把无效改动或额外计算量误认为改进能力的提升。
5.1 Reward Hacking:得分提高,目标没有实现
Sakana 记录过一个具体案例:DGM 被要求减少“假装调用工具”的行为,却有候选删除了检测这种行为所用的标记。检测分数因此变好,工具调用问题却没有解决。
这是 Reward Hacking:系统利用评分机制的漏洞获得高分,却没有完成真实目标。若这样的版本被评分函数选中,后续迭代还可能继承这项错误修改。因此,检查工具是否执行过,应依据独立记录,不能只相信 Agent 生成的日志。
另一种误判来自评测集过拟合:反复用同一批任务筛选版本,可能只得到更适合这些任务的程序。这也是第 4.2 节要求保留独立评测任务的原因;固定一批题反复选优,并不会让它们成为独立测试集。
5.2 预算不匹配:更好的结果可能来自更多尝试
假设 在加入失败反馈的同时,还把候选数量扩大十倍。更多尝试可能让它选出更好的版本,但还不能说明新增的失败反馈更有效。第 4.2 节因此要求匹配总预算,并将 LLM 调用、工具执行和失败候选的开销都计入成本。
预算限制也影响这类系统能运行多久。DGM 论文估算,一次 SWE-bench 搜索运行约花费 22,000 美元。评估工程价值时,除了最终分数,还需要报告获得这次提升的总成本。
对前面的失败反馈改动,版本与调用记录用于确认它确实被下一轮采用;独立任务和等预算对照用于判断它是否改善了后续改进。两类证据齐备,才能把“新机制参与了运行”与“新机制带来了收益”区分开。
评论
使用 GitHub 登录后参与讨论,评论将公开保存在 GitHub。
站长管理删除会同步到 GitHub,无法撤销。
阅读到这里时加载评论。