FlashAttention、KV Cache 与 PagedAttention
注意力计算中的显存读写、历史 KV 复用与分页管理。
FlashAttention 是一种精确注意力算法,通过分块计算和算子融合减少显存读写,加快计算并降低显存占用。
KV Cache 是自回归生成中的键值缓存,保存并复用历史 token 的 Key、Value,减少重复计算。
PagedAttention 是一种借鉴虚拟内存分页思想的注意力算法,按块管理 KV Cache,减少显存浪费并支持缓存共享。
1. FlashAttention
1.1 背景
自注意力(Self-Attention)的计算量和中间矩阵大小都会随序列长度平方增长,长上下文因此带来较大的计算和显存开销。
FlashAttention 是一种 IO-aware(感知内存读写开销)的精确注意力算法。它利用 GPU 的存储层次减少数据搬运:
- HBM(High Bandwidth Memory,高带宽内存):容量较大的 GPU 显存,存放输入、输出等数据。
- SRAM:容量小、访问更快的片上存储,适合保存当前计算所需的数据块。
FlashAttention 的稠密注意力计算量仍为 ;固定头维度 时,注意力计算所需的显存随序列长度 线性增长。
它没有采用稀疏或低秩近似,计算的注意力与标准方法在数学上相同;浮点计算顺序不同,结果可能存在舍入误差。
1.2 传统 Attention
对于单个注意力头,输入 、、 的形状都是 , 为序列长度, 为头维度。省略缩放系数和 mask 时:
softmax 按行计算。 是注意力分数, 是归一化后的注意力权重, 是输出。
传统实现需要将中间矩阵 、 写入 HBM,计算流程为:
- 从 HBM 分块读取 、,计算 ,将 写回 HBM。
- 从 HBM 读取 ,计算 ,将 写回 HBM。
- 从 HBM 分块读取 、,计算 ,将 写回 HBM。
- 返回 。
、 都是 的矩阵,既占用显存,也产生大量读写。
1.3 分块计算与重计算
FlashAttention 将 、、 划分为块(block),把当前需要的块从 HBM 加载到 SRAM,在片上完成融合计算。这种分块方式称为 Tiling。
目标是避免完整的注意力矩阵 、 在 HBM 中反复读写,需要解决两个问题。
一是分块计算 softmax。 普通实现需要拿到一整行分数,归一化得到注意力权重,再与 相乘。FlashAttention 会多次遍历输入块,每处理一块,就更新每行的最大值、指数和及输出累积值。遇到新的最大值时,对之前的累积值做相应缩放,因此不需要同时保存整行分数。
分块计算仍会处理所需的全部 token。softmax 按行归一化,不同行之间可以并行计算。
二是反向传播时不保存完整的中间注意力矩阵。 前向计算保留输出和每行的 softmax 归一化统计量。反向传播时,利用 、、 等数据,在 SRAM 中重算当前块的注意力,并计算梯度,这就是 Recomputation(重计算)。
重计算多做了一部分浮点运算,但省去了大矩阵的存储和读取,在原论文的测试中反而更快。、 的每个块算完就不再保留,写回 HBM 的只有输出和必要统计量。
- Fast:分块加载和算子融合减少耗时的 HBM 访问。
- Memory-Efficient:不在 HBM 保存完整的 、,反向传播按需重算。
- Exact Attention:保留完整注意力计算,分块过程不引入稀疏或低秩近似。
1.4 效果与应用
FlashAttention 初版发布时,相比当时经过优化的注意力实现,速度约为后者的 2–4 倍。在官方与 PyTorch 标准注意力的显存对比中,序列长度为 1K–4K 时,显存占用约降至 1/5–1/20。
实际收益取决于硬件、序列长度和实现版本。
FastChat 的 LLaMA 训练实现接入了 FlashAttention。
ChatGLM2-6B 官方说明称,基于 FlashAttention,基座模型的上下文长度由 ChatGLM-6B 的 2K 扩展至 32K,对话阶段使用 8K 上下文训练。
2. vLLM
vLLM 是大语言模型推理与服务引擎。KV Cache 用来减少自回归生成中的重复计算,PagedAttention 则是 vLLM 管理 KV Cache 的关键方法。
2.1 KV Cache
以 GPT 为代表的 Decoder-Only 自回归语言模型,每生成一个新 token,都需要依赖之前的 token。如果没有 KV Cache,每轮把完整前缀输入模型,就会重复计算历史 token 的表示。
下图中,输入“我/是/一/个”生成“好”。生成“人”时,输入变为“我/是/一/个/好”,历史位置的 、、 又计算了一遍。
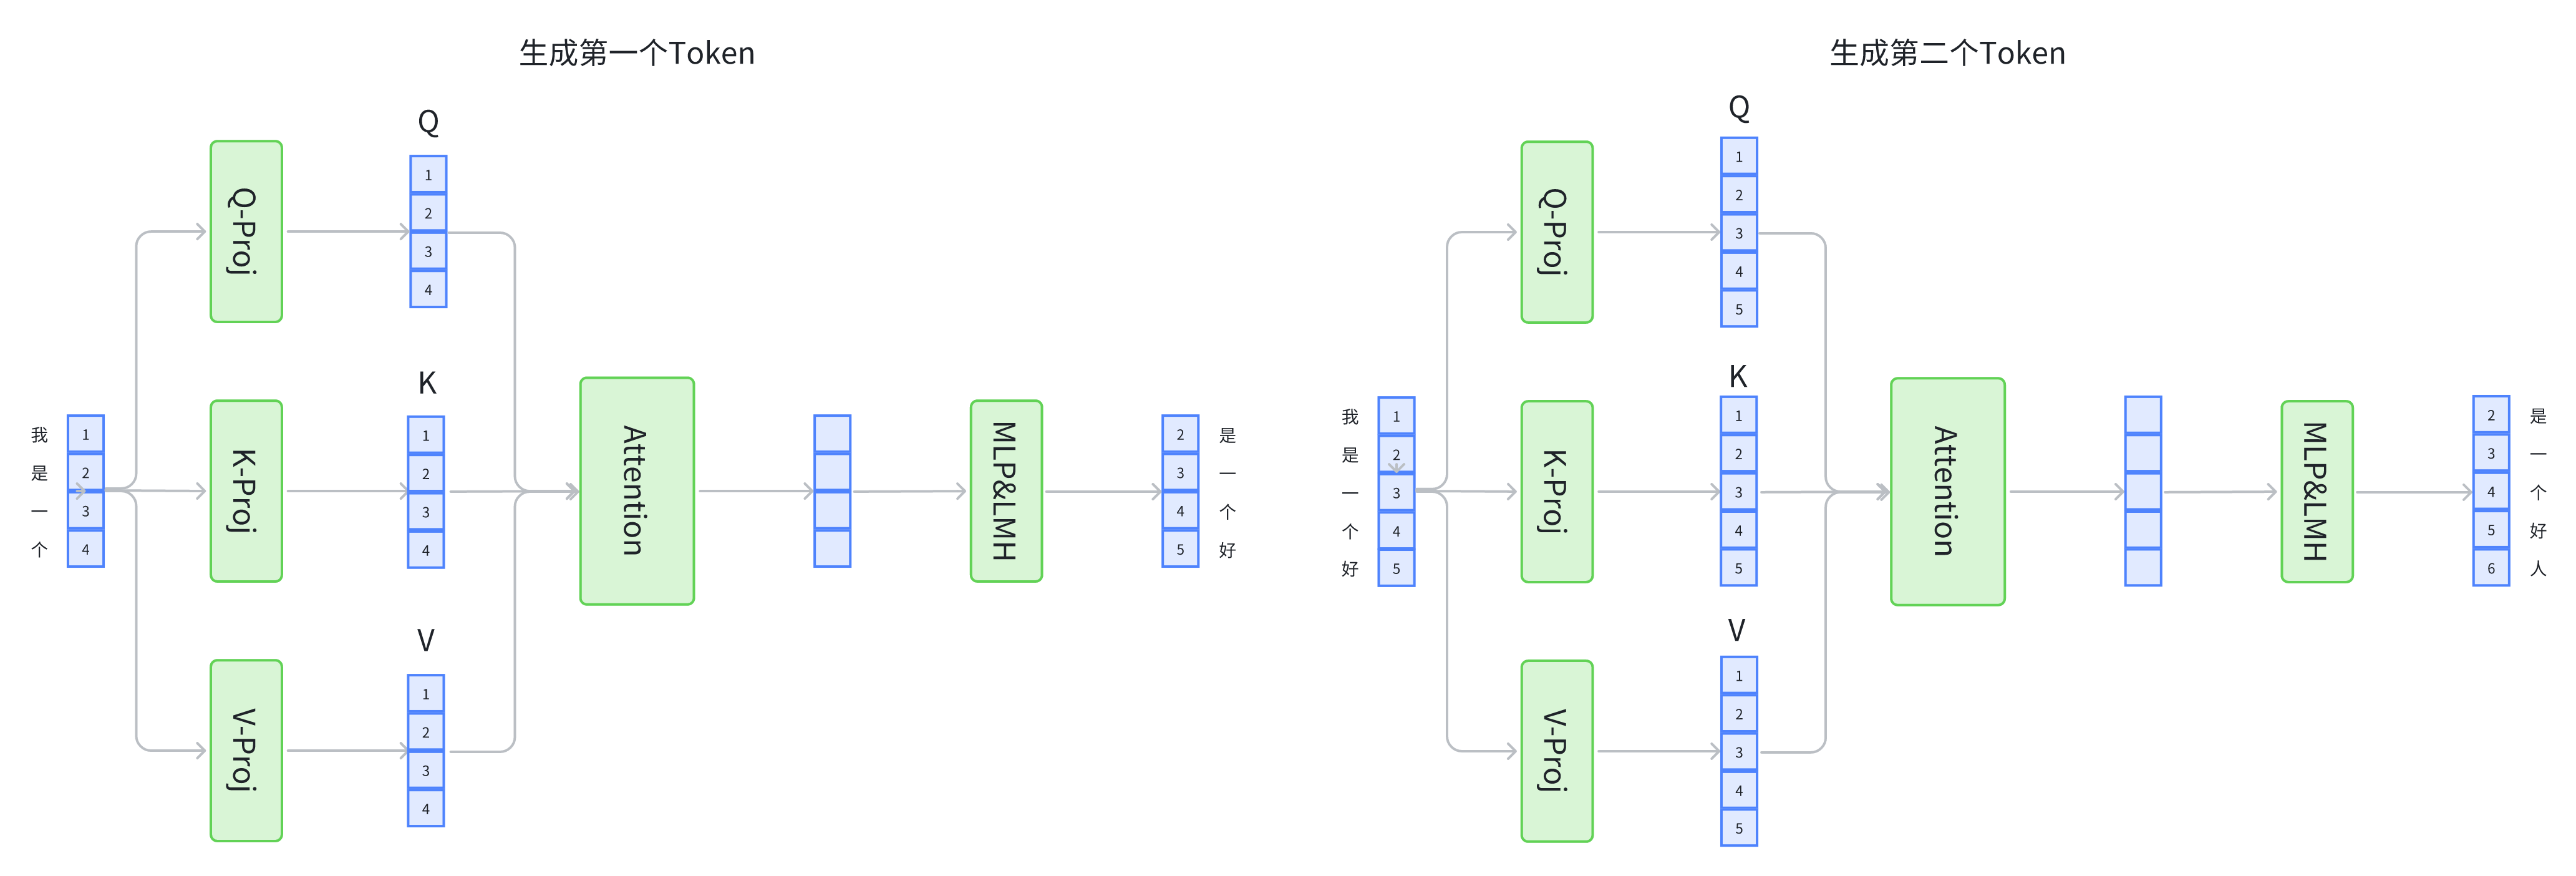
KV Cache 将每层 Transformer 已计算的 Key、Value 保存下来,后续生成时直接复用。 因果注意力下,历史位置不能关注后续新 token,所以新 token 不会改变历史位置已有的 Key、Value。使用 KV Cache 通常分为两个阶段:
预填充阶段(Prefill)
初次处理提示词时,Cache 为空。模型计算整段提示词,在每个 Transformer 层保存对应的 Key、Value,并根据最后一个位置的输出预测首个新 token。
这一阶段的主要浮点运算量与关闭 KV Cache 时相近,包含大量 GEMM(General Matrix Multiply,通用矩阵乘法)。提示词较长时,prefill 通常受计算能力限制,也就是 Compute-bound。首个 token 要等整段提示词处理完才能生成。
解码阶段(Decode / KV Cache 阶段)
生成第二个及后续新 token 时,Cache 已有历史 Key、Value。每轮只为当前新输入的 token 计算 、、,将新的 、 追加到 Cache。当前 仍要与缓存中的全部有效 、 一起完成注意力计算。
历史 token 不用重新算一遍,浮点运算量随之下降。单序列、逐 token 解码时,许多矩阵乘法变成了 GEMV(General Matrix Vector Multiply,通用矩阵向量乘法)。这时通常更受权重和 KV Cache 的读取带宽限制,也就是 Memory-bound。
每步解码的耗时通常短于一次长提示词的 prefill。batch 较大时,矩阵乘法的形状和主要瓶颈都会变化,不能把所有解码都看成 GEMV。
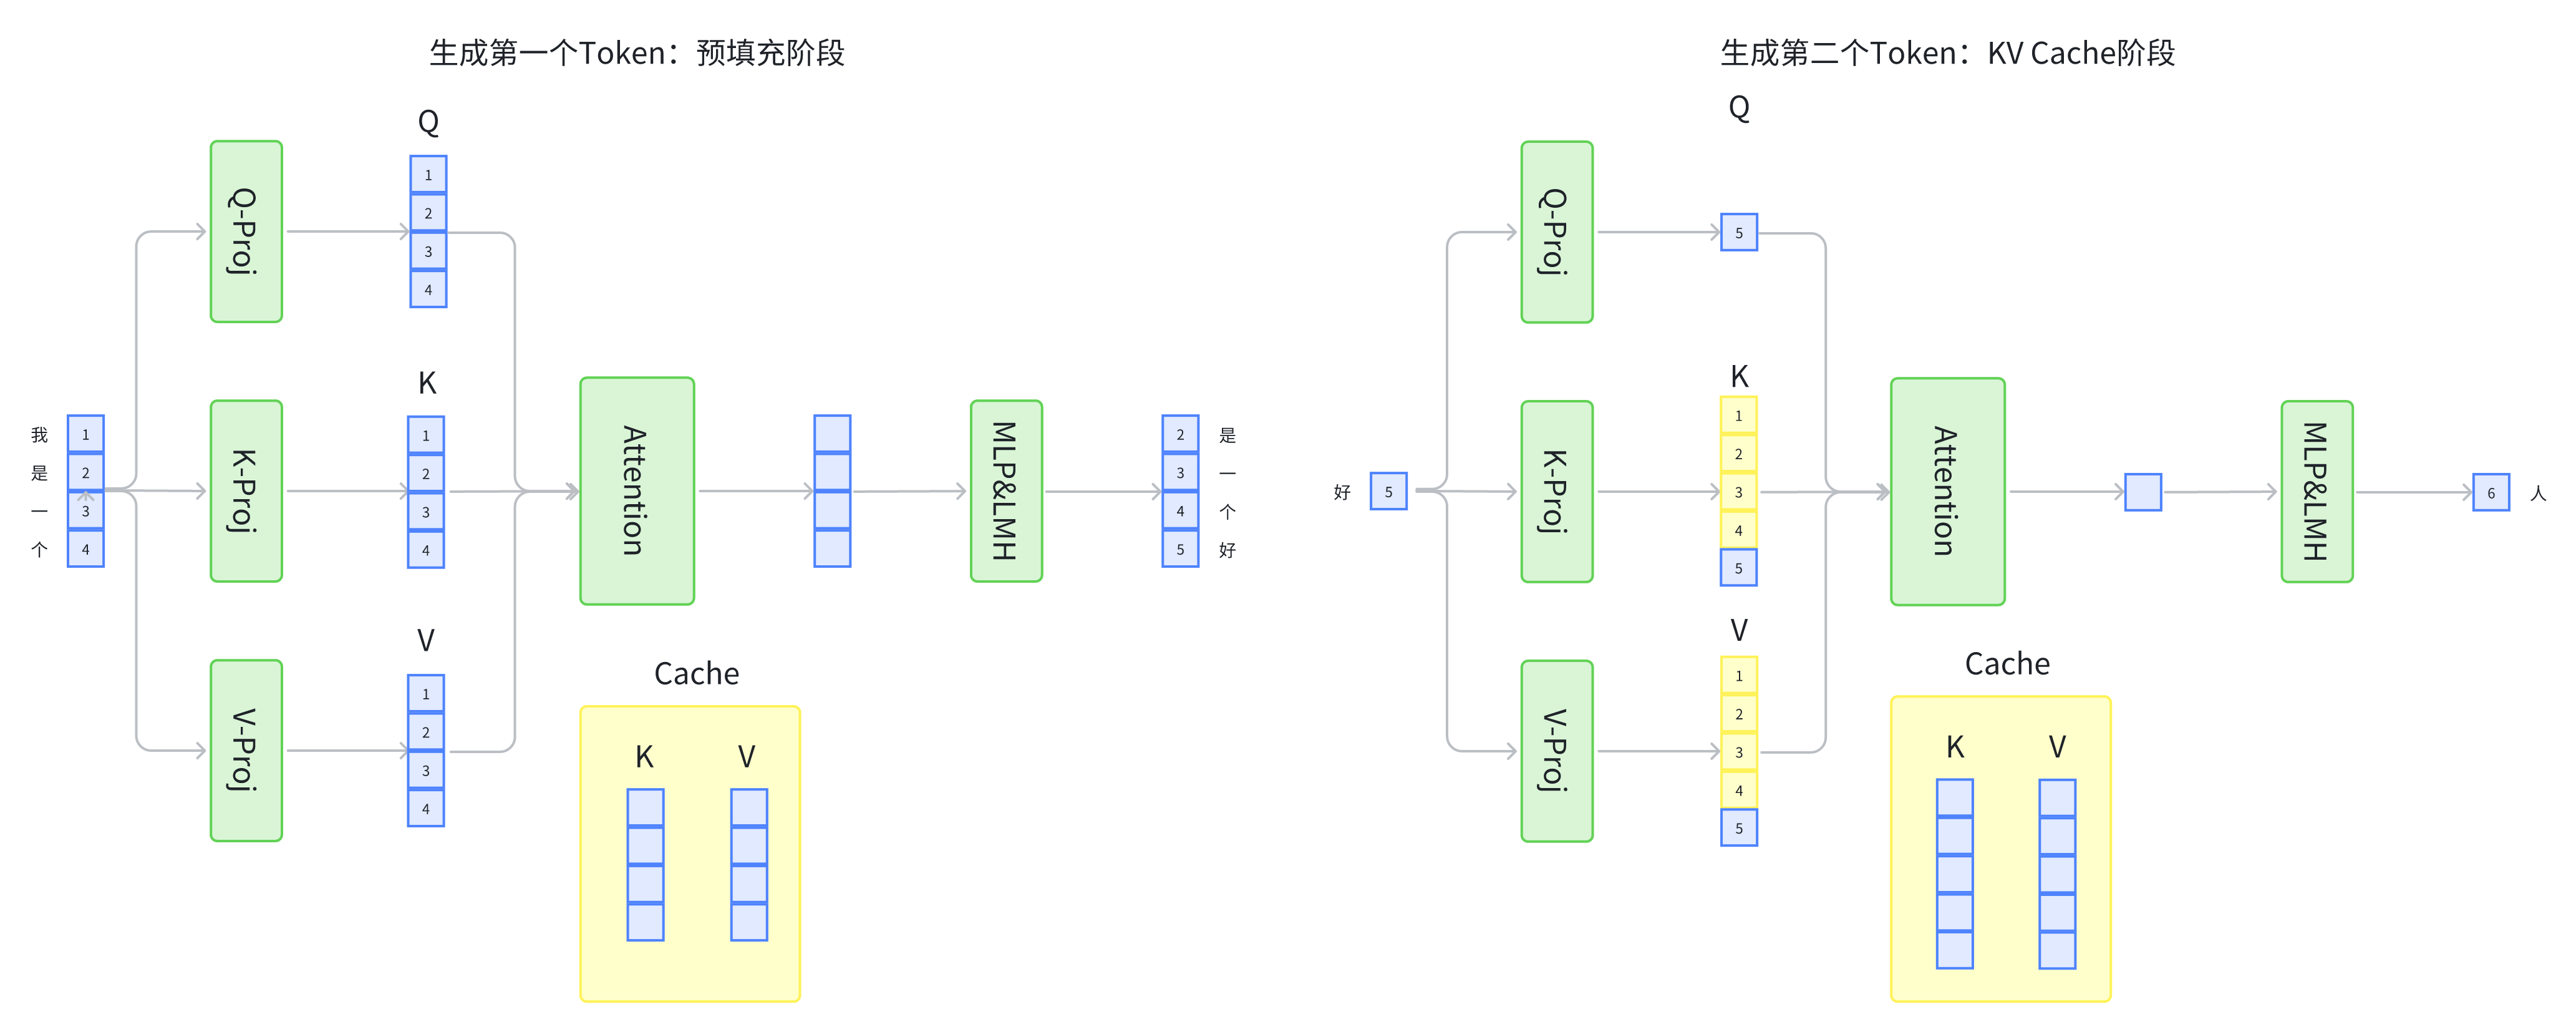
图中黄色部分是已有的 KV Cache,蓝色部分是当前计算得到的数据。处理“好”时,只计算它对应的 、、,复用“我/是/一/个”的 、,就能预测“人”。
两张图是简化示意,省略了多层堆叠和因果 mask。左侧展示了各位置的下一词预测,实际生成时使用最后一个位置预测新 token。KV Cache 随序列增长而增加显存占用,解码仍需要读取历史 KV。
2.2 PagedAttention
PagedAttention 借鉴操作系统的虚拟内存和分页思想,允许逻辑上连续的 Key、Value 存放在物理上不连续的显存块中。
它将每个序列的 KV Cache 分成多个块,每块容纳固定数量 token 的 Key、Value。 注意力计算时,PagedAttention kernel 根据映射找到并读取这些块,完成并行计算。
2.2.1 内存布局
块在显存中不需要连续存放,管理方式类似操作系统的虚拟内存:
- 块对应页,每块容纳固定数量 token 的 KV。
- token 对应字节,这只是类比,不代表一个 token 的 KV 只占一个字节。
- 序列对应进程,每个序列拥有自己的逻辑块。
块表将连续的逻辑块映射到非连续的物理块。 随着新 token 生成、序列变长,系统按需分配物理块,无需为每个请求预留一整段最大长度的连续空间。
按需分配时,只有序列的最后一个块可能没填满。 vLLM 在 2023 年的官方介绍中提到,实际的显存浪费低于 4%。这个比例会随块大小和序列长度变化,不能保证所有输入都低于 4%。
显存浪费减少后,同一张 GPU 能容纳更多序列,增大 batch size,提高 GPU 利用率和整体吞吐量。
2.2.2 内存共享
并行采样时,同一个提示词会生成多个输出序列。这些序列能共享提示词部分的计算结果和 KV Cache。
例如,同一提示词
She is eating生成She is eating food和She is eating apple两个分支时,She is eating对应的 KV 可以共享,分叉后的内容分别保存。
不同序列把自己的逻辑块映射到同一个物理块,就能共享已有 KV。PagedAttention 用引用计数记录有多少序列正在使用这个物理块。某个分支需要修改共享块时,就为它复制一份,其他序列继续使用原来的块。这就是 Copy-on-Write(写时复制)。
例如,共享的最后一块还没填满,两个分支却要在剩余位置写入不同 token 的 KV,这一块就需要分开保存。已经填满、不再修改的前缀块继续共享。
评论
使用 GitHub 登录后参与讨论,评论将公开保存在 GitHub。
站长管理删除会同步到 GitHub,无法撤销。
阅读到这里时加载评论。