模型推理加速:ONNX、图优化与低精度计算
ONNX、图优化、FP16 与 INT8 如何加速模型推理,以及性能比较中容易忽略的问题。
模型推理慢,可以尝试图优化、低精度计算,也可以通过剪枝、蒸馏缩小模型。但模型算得更快,未必能让服务响应明显变快:分词、数据传输和请求排队也会消耗时间。
1. 推理加速到底在优化什么?
先确定要缩短单次请求的等待时间,还是提高单位时间内处理的样本数。 两者都叫“更快”,优化方向却不完全相同。
- 延迟:完成一次请求需要多久。在线服务还应看 P95、P99,分别表示约 95%、99% 的请求能在该时间内完成。
- 吞吐:单位时间完成多少请求或样本。批量处理可能提高吞吐,但凑齐一批所需的等待也会增加请求延迟。
- 模型体积与运行内存:前者影响存储和分发;后者还包括中间张量、算子工作区等,不能只用模型文件大小估计。
- 任务效果:分类的准确率、F1 或关键类别召回率,需要满足业务要求。数值表示的“精度”和分类的“准确率”是两个概念。
比较同一工作负载时,加速比为:。例如耗时从 20 ms 降至 5 ms,加速比是 4,耗时减少了 75%。
模型更小,不保证请求更快;吞吐更高,也不保证单条请求等待更短。
2. ONNX、ONNX Runtime、TensorRT 是什么关系?
ONNX 描述模型怎么算,运行时和硬件后端决定它具体怎样执行。
| 名称 | 负责什么 | 在部署中的作用 |
|---|---|---|
| ONNX | 定义计算图、算子及数据类型 | 将模型表示为可被不同工具读取的格式 |
| ONNX Runtime,简称 ORT | 加载模型、优化图、调度执行 | 通过不同执行后端运行模型 |
| TensorRT | 面向 NVIDIA GPU 优化并执行模型 | 可直接用于部署,也可作为 ORT 的执行后端 |
常见的部署路线:
| |
这里的执行后端叫 Execution Provider,简称 EP。
配置了 CUDA 或 TensorRT EP,不代表所有节点都会交给它执行。ORT 会根据后端支持情况划分子图;未被优先后端接收的部分可能交给后续后端。因此,算子支持范围、子图之间的数据传输,都可能影响速度。
导出 ONNX 的直接价值是得到明确的模型表示和部署接口,速度收益需要在实际执行中验证。 导出成功后,还要检查输入名称、数据类型、形状和输出含义是否一致。
以 BERT 分类为例,输入通常包含 token 编号、注意力掩码和句段编号,输出为各类别的原始分数 logits。词表、截断规则和标签映射也要保持一致;只有模型文件转换正确,仍不足以保证整个分类服务行为一致。
PyTorch 可以用 torch.onnx.export 导出 ONNX,官方推荐设置 dynamo=True。导出时有两项设置需要注意:
- 动态维度:batch 大小或文本长度需要变化时,用
dynamic_shapes声明这些维度;否则导出的模型可能只接受示例输入的形状。 - 算子集版本:
opset_version决定采用哪一版 ONNX 算子定义,需要同时满足模型导出和目标运行时的支持范围。
3. 图优化为什么能加速?
图优化通过消除重复计算、合并操作和调整数据布局,减少执行成本。 它通常不需要重新训练模型。
- 常量折叠:某段计算只依赖常量,就可以预先算好结果。推理时直接使用结果,避免每次执行同样的计算。
- 算子融合:将符合条件的一组操作交给融合实现。例如线性计算后的偏置相加可以合并处理,减少算子调度及中间结果的读写。
- 布局优化:调整张量的存放与访问方式,使其更适合目标硬件的计算内核。
这些优化依赖具体图结构和后端支持,不能仅凭节点数量判断效果。一个融合节点可能包含原先多个节点的计算;图看起来更短,不等于数学运算量按相同比例减少。
ORT 图优化 可以在创建会话时进行,也可以将优化图保存下来供后续加载。会话初始化和优化的时间应与稳态推理时间分开记录;离线优化产物还可能依赖目标后端和硬件配置。
4. 为什么 batch、序列长度和硬件会改变结果?
加速比取决于模型实际处理的工作量,以及当前耗时主要花在计算、访存还是调度上。 小 batch 下明显的收益,换成大 batch 或长文本后可能缩小。
batch 大小:平均到每条更快,不等于整批更快
下面是一组 BERT 分类模型在 CPU、T4 和 V100 上的 batch 对比。图中 baseline、jit、onnx 分别表示 PyTorch 基线、JIT 和 ONNX 推理方案;纵轴为 batch 大小,数值是平均每条序列耗时,单位为 ms。
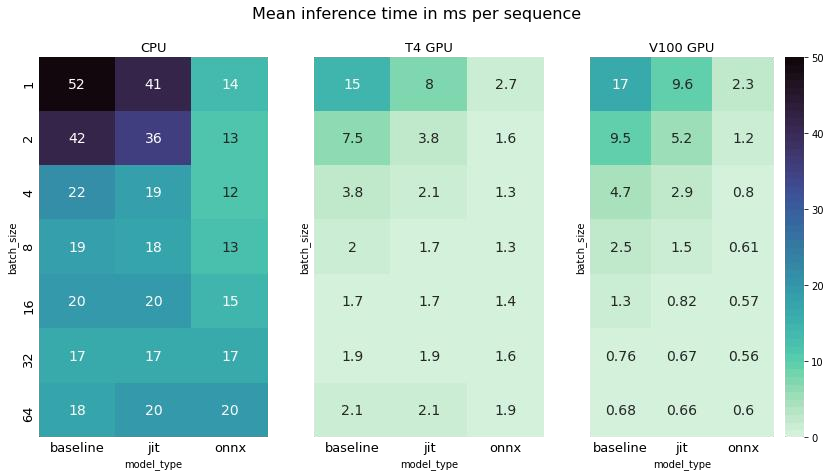
CPU 图中,batch 为 1 时,基线与 ONNX 分别为 52 ms、14 ms;batch 为 32 时都是 17 ms;batch 为 64 时则为 18 ms、20 ms。这组数据支持“收益随 batch 改变”,不能把 32 当成所有 CPU 和模型通用的分界。
若整批耗时为 、批大小为 ,则平均每条耗时为 。它将整批成本分摊到每条样本上,不包含在线服务为凑齐这一批而额外等待的时间。
序列长度:动态形状和实际 padding 要一起看
下面比较 V100 上不同输入长度的情况,数值仍是平均每条序列耗时,单位为 ms。图中 batch 为 1 时,128 token 组的基线与 ONNX 为 18 ms、3.7 ms,512 token 组为 17 ms、11 ms;两组的相对收益明显不同。
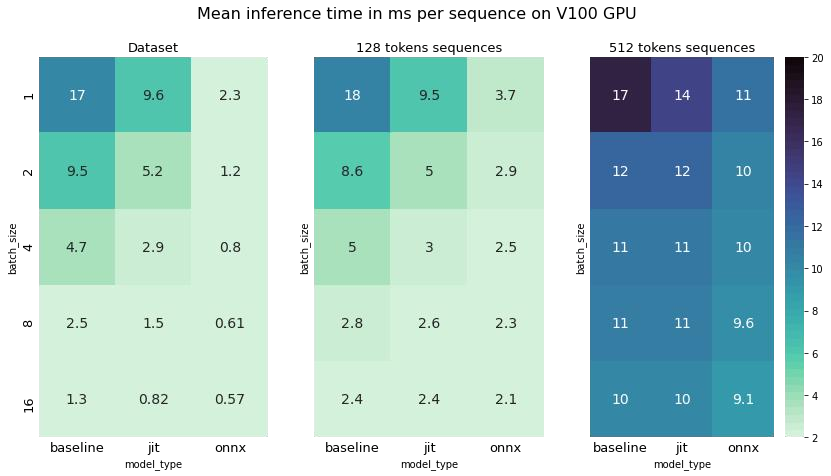
对于常规稠密 BERT,实现仍会处理 padding 后的张量。注意力掩码控制哪些位置参与有效注意力,并不自动跳过所有补齐位置的计算。长度改变了计算和中间张量规模,也可能改变算子选择与硬件利用率。
例如,同一批文本的最长长度是 80 token,固定补齐到 500,与只补齐到批内最长的 80,送入模型的计算量就不同。这两种 padding 策略都可以用于 PyTorch 或 ONNX 部署。声明动态维度,只是允许输入形状变化;真正送入什么形状,由预处理决定。
因此,比较两条部署路线时要统一截断和 padding 规则。按长度分组、减少无效补齐,也值得作为独立优化项测试。
硬件:算得快,还要考虑数据怎样进出
CPU 与 GPU 擅长的计算方式不同,同一种低精度格式也需要匹配的内核和硬件支持。GPU 推理还可能包含 CPU 到 GPU 的输入拷贝,以及结果返回 CPU 的开销。
使用 CPU 上的 NumPy 数组调用 GPU EP 时,这些传输可能发生在 session.run 内部。若数据本来就留在 GPU 上,可评估 I/O Binding 以减少不必要的往返;端到端服务测试仍应包含业务实际需要的数据传输。
5. FP16、INT8、剪枝和蒸馏分别改变什么?
FP16、INT8 改变数值表示或计算路径;剪枝、蒸馏则可以让模型本身变小。 它们可以组合,但收益和代价需要分别记录。
| 方法 | 主要改变 | 需要关注的代价与条件 |
|---|---|---|
| FP16 | 用 16 位浮点数表示部分或大部分原有 FP32 数据 | 表示范围与有效位数改变;依赖后端支持,必要时保留部分 FP32 运算 |
| INT8 量化 | 用 8 位整数及缩放参数近似表示权重、激活等数据 | 会产生量化误差;实际加速依赖量化算子及硬件支持 |
| 结构化剪枝 | 移除注意力头、前馈网络(FFN)通道等结构,缩小计算规模 | 可能损失任务效果,通常需要评估并考虑恢复训练 |
| 知识蒸馏 | 用教师模型的输出或中间表示指导学生模型训练 | 需要额外训练;推理成本取决于最终选择的学生模型 |
FP32 权重改为 FP16 后,每个被转换权重的存储位数减半,但整个模型可能保留 FP32 节点和转换操作。文件大小、运行内存和耗时不能都按“一半”计算。若某些运算对误差敏感,可以采用混合精度,让它们继续使用 FP32。
INT8 量化通过缩放参数连接浮点值与整数值,并非直接将浮点数截成整数。常见的动态、静态量化,关键区别在于激活值的量化参数何时确定:
- 动态量化:推理时根据当前激活值计算缩放参数,一般不需要预先提供校准数据,但会增加这部分运行开销。
- 静态量化:提前用有代表性的校准数据确定参数,推理时复用。校准数据若不能覆盖实际输入分布,可能影响任务效果。
INT8 量化也可用于 GPU 推理,例如 ORT 的 TensorRT EP;能否加速取决于模型、算子和硬件是否支持。ORT 还支持部分算子的 INT4 权重量化,但位数更低并不自动意味着更快,量化和反量化开销也要计入。具体支持范围可查阅 ORT 量化文档。
对 BERT,可以通过结构化剪枝减少注意力头数、缩小 FFN 宽度,也可以用较浅的学生模型接受蒸馏训练。这些做法减少了实际计算规模;仅把权重置零、仍由普通稠密算子执行,并不一定减少推理耗时。
一种实践顺序:先 FP16,再图优化,再 INT8
对支持这条转换链路的 BERT 分类模型,可以按下面的顺序尝试,并在每一步比较任务效果和性能:
| |
如果还要剪枝或蒸馏,应先确定最终模型结构,再处理部署转换。FP16 并不是所有 INT8 方案的前置要求;量化工具可能要求输入 FP32 模型,因此要按工具和后端支持选择链路,保留各阶段模型以便比较或回退。
一组 BERT 分类模型的联合优化实验,按以下步骤逐步压缩模型:
- 训练或蒸馏小模型:以
rbt3为起点,模型体积约 150 MB。 - 剪枝:对训练好的 PyTorch 模型剪枝,尽量保留任务效果,体积降至约 120 MB。
- 导出与优化:将剪枝后的模型导出为 ONNX,再做 FP16 转换和图优化,体积降至约 63 MB。
- INT8 量化:对优化后的模型进一步量化,体积降至约 30 MB。
最终模型文件如下:

实验记录的整体结果是:模型体积压缩约 13 倍,CPU 推理速度约为基线的 15 倍,代价是“精度降低 3 个点”。 这些收益来自模型结构调整与部署优化的共同作用。
记录未注明 13 倍压缩的比较基线,也未说明“精度”的具体指标。上面从 150 MB 到 30 MB 的阶段变化约为 5 倍压缩,两者不能混为一谈;换模型或运行环境后,速度与任务效果仍需重新测量。
6. 怎样确认优化真的有效?
先验证结果,再比较相同条件下的速度,最后检查真实服务是否受益。 每次优化都保留上一阶段产物,才能判断收益和损失发生在哪一步。
- 验证模型行为与任务效果。 保持 tokenizer、输入预处理、标签映射一致。导出或图优化后,比较代表性输入上的 logits 与允许误差;低精度、剪枝或蒸馏后,还要用相同评估集检查准确率、F1 和关键类别表现,不能只看几条预测是否相同。
- 固定性能比较条件。 除本次优化项外,固定机器、线程配置、batch 和输入长度分布,并记录精度设置;先预热,再多次测量。比较运行时本身时固定模型结构与数值精度,比较完整方案时则明确记录同时改变了哪些因素。
- 明确计时边界。 分开记录加载与首次运行、稳态模型执行、包含分词和后处理的端到端耗时。GPU 计时应保证被测工作真正完成,不能只量到异步提交;服务测试还应固定并发与请求负载,记录吞吐和延迟分位数。
性能对比至少留下一条完整记录:模型及优化步骤、软硬件版本、执行后端、输入与并发设置、计时范围、任务指标。若量化让模型执行更快,但分词或请求排队占了主要耗时,用户感知到的改善仍可能很小。
部署工具可以按运行环境选择:
- ONNX 与 ORT:需要统一模型表示、跨语言运行,或接入多种执行后端。
torch.compile:模型继续在 PyTorch 中运行,通过编译优化其执行过程。- TensorRT:面向 NVIDIA GPU 部署。
这些方案也能组合,例如 Torch-TensorRT 可作为 torch.compile 的后端。选型时,除了推理速度,还要考虑导出兼容性、编译耗时和模型升级的维护成本。
评论
使用 GitHub 登录后参与讨论,评论将公开保存在 GitHub。
站长管理删除会同步到 GitHub,无法撤销。
阅读到这里时加载评论。